データサイエンティスト基礎トレーニングコースの概要(パート4):モデル構築には主に2つのトピックがあります。データにターゲットがない場合は、教師なし機械学習手法が使用されます。このセクションでは、 クラスタリング:K平均法 。ターゲットがある場合は、教師あり機械学習手法が使用されます。詳細については、続きをお読みください。
1. 教師なし機械学習
1.1 クラスタリング
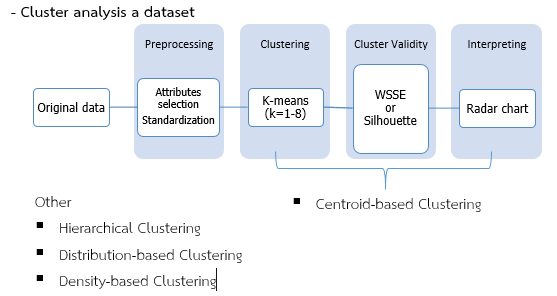
K平均法
類似した行動パターンに基づいて顧客を自動的にグループ化するために、
教授はK平均法を推奨しました。この方法は開始点を無視し、代わりに手動で開始点を変更して選択します。プログラムはモデルを複数回実行し、最適な値を選択します。K平均法の数値が得られたら、適切なグループを選択する方法は、グループ内の各点の平均値の合計(WCSSE)をグラフにプロットし、最も急なカーブを持つ点を見つけることです。急なカーブが多い場合は、常に最も右側の点から選択してください(グループ数が多いほど、それらが一緒にグループ化される可能性が高くなるため)。
次に、Visualize - Radar chart を使用してデータを表示および解釈します。
2. 教師あり機械学習
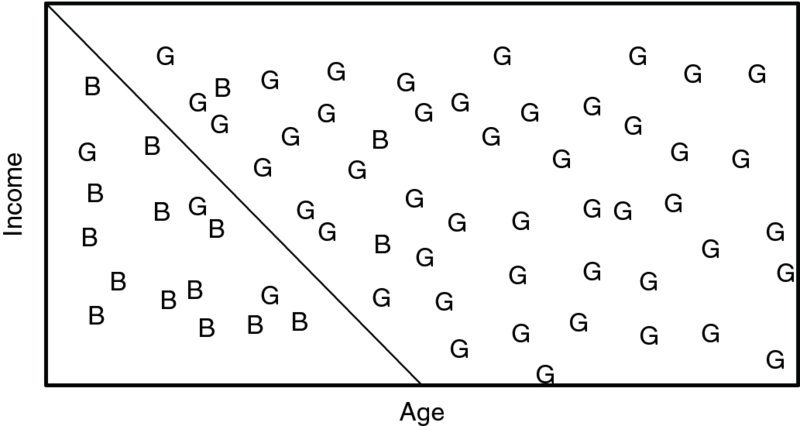
2.1 の予測分析 (分類)
モデルを構築するには、入力データを予測するための対象データが必要です。例えば、顧客が優良顧客か不良顧客かを予測するには、どのような顧客が優良顧客で、どのような顧客が不良顧客であるかを示すサンプルデータを特定する必要があります。次に、モデル構築とテストのためにデータを分割し、最後にモデルを評価して有効性を確認します。
モデルの評価と選択
モデルを評価し、アプリケーションに最適なモデルを選択する際には、混同行列を考慮する必要があります。
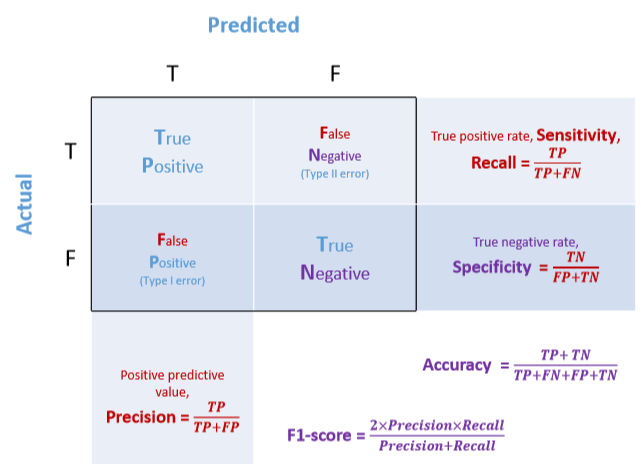
モデルの有効性は、精度と再現率の両方を考慮したF1スコアを用いて評価されます。F1スコアが高いほど、モデルの性能が高いことを示します。次に、期待値を計算して有効性を評価します。期待値が低いほど望ましいとされます。
– 予測分析分類モデル:
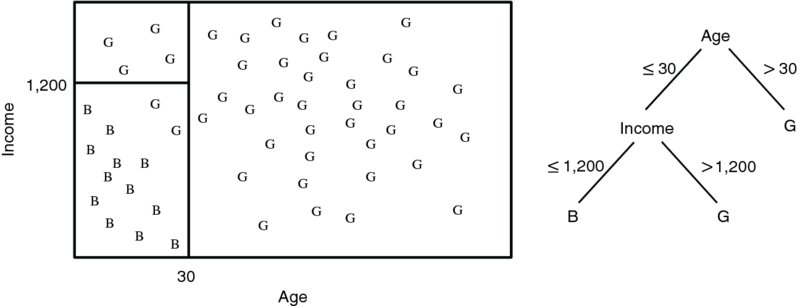
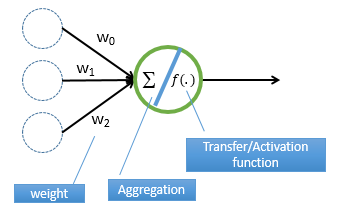
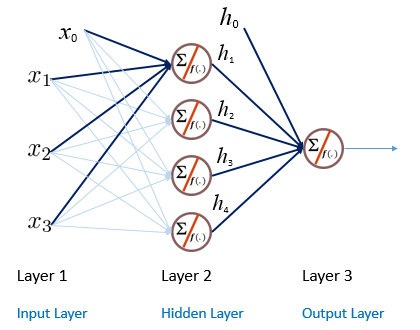
教授は、ロジスティック回帰、決定木、ニューラルネットワークという3つの追加手法を推奨しました。モデルを構築するたびに、テストを行い、混同行列を用いて評価し、前述のように最適なモデルを選択する必要があります。
2.2 連続値に対する予測分析
機械学習モデルは、線形回帰
、多項式回帰
、ニューラルネットワーク
など、さまざまな手法を用いて数値予測に利用できます
その後、講師は実習を行い、Weka、Python、Sparkを紹介し、さまざまなソフトウェアプログラムを使用してモデルを構築する方法を実演し、データ分析プロセスを明確に示します。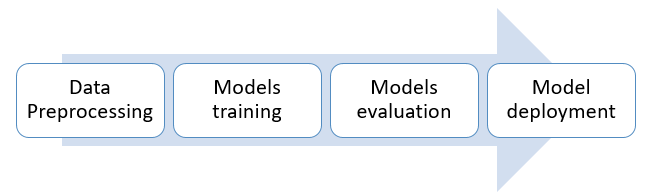
外れ値が存在し、異常なデータが事前に調整されていない場合、モデルは実際には使用できなくなる可能性があり、結果として得られる平均値は通常よりも高くなります。
講演者:Pairasan Padungwiang博士(
R&D BI Co., Ltd.)
編集:Nuchanat Rongrong
www.rdbi.co.th
#コンサルタント
#データサイエンティスト
#ビッグデータ分析
データサイエンスの基礎に関する記事集。
詳細については、 https://demo.rdbi.co.th/contact/ にアクセスするか、
http://bit.ly/rdbipage をご覧いただくか、をフォローする
LINE 公式アカウント@rdbi
か、sales@rdbi.co.th までメールでお問い合わせください。