研修日程:2019年11月14~15日、21~22日、28~29日(計6日間)。
データクレンジングは 、モデル構築、データ分類、欠損値処理、外れ値特定などの準備作業です。詳細については、以下をお読みください。
データエンジニアの仕事:データクレンジング
データは2種類に分けられます。
– カテゴリデータのグループ化は、順序尺度(数値データを順序立ててグループ化する)、二値尺度(アルファベット順にグループ化する)、名義尺度(名詞の特性に基づいてグループ化する)の3つのサブグループに分けられます。
– 連続数値データ
分析を可能にするためのデータ操作には、名義データをカウントによって変換すること、連続する数値データを順序データに変換すること、データを等間隔に分割すること、または各間隔の頻度をカウントすることなどが含まれる。
欠損値の処理
モデル構築のためのターゲットデータの処理について、例えば顧客離脱を予測したい場合、離脱した顧客と離脱していない顧客のデータを2つのグループに分けて用意する必要があります。使用するデータの量はほぼ均等な割合にするべきであり、すべての顧客データを予測に使用すべきではありません。
収入や給与、婚姻状況、信用情報機関の記録など、顧客が開示を望まない情報を扱う方法は3つあります。
– 欠損値は類似の値で置き換えます。信用情報機関のレポートの場合は、欠損値の置き換えに平均値または中央値を使用します。ステータス レポートの場合は、欠損値の置き換えに最頻値を使用します。
– 削除します。
– 重要な情報は保持しますが、分類します。たとえば、収入の場合、データがない場合は収入がないことを意味します。おそらくその人は失業中であるなどです。
外れ値を見つけ出し、その結果を表示することで、データ内の異常を強調する。
分析用のデータ準備には、図に示すように、異常値を特定し、標準偏差(SD)または初期半径(IQR)を使用してそれらを計算する必要があります。
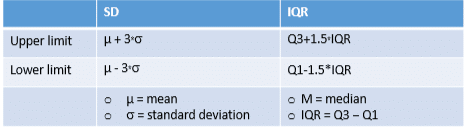
異常値を検出するために、ファイサン教授は標準偏差(SD)よりも信頼性の高い四分位範囲(IQR)を使用することを推奨している。
標準化と は、データを[0, 1]や[-1, +1]などの目的の範囲にスケーリングするプロセスです。標準化には、
1)図2に示すような最小値/最大値標準化、
2)図3に示すようなZスコア、
3)図4に示すような小数スケーリングの3つの方法があります。
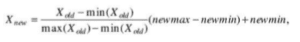
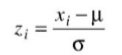

データのスケーリングはモデル構築を高速化し、各変数が等しく重要となることを保証する。
実習:PythonとSparkを使用して、欠損データの処理と異常値の検出を行う。
一般的なデータ分析には、WekaまたはPythonが推奨されます。大規模なデータセットの場合はSparkを使用すべきですが、人材育成とデータストレージに高額なコストがかかります。
ヌチャナット・ロンロン氏(講師)、ファイサン・パドゥンウィアン博士
(R&D BI Co., Ltd.)
が編集。
データサイエンスの基礎に関する記事集。
詳細については、 https://demo.rdbi.co.th/contact/ にアクセスするか、
LINE公式アカウント( @rdbi)
で
。