このガイドでは、テキストデータの管理方法、モデル構築のためのデータ準備方法、およびテキストデータを表形式の数値データに変換する方法について解説します。詳細については、以下をお読みください。
1. テキストデータの管理方法
データには、以下のようないくつかの種類があります。
– 構造化データ:データベースに保存されているデータ。
– 半構造化データ:XML、JSON、CSV、および一部のNoSQLデータベース。
– 非構造化データ:テキスト、写真、ビデオ、および音声。
テキストデータの管理は、スペルミス、誤解釈(肯定的または否定的)、文書内の大量のテキスト、場合によっては複数のファイルが単一の文書として扱われるなど、さまざまな側面があるため、データ前処理の観点から複雑です。
モデル構築のためのデータ準備や、テキストデータを表形式の数値データに変換する方法はいくつかあり、以下に示します。
バッグ・オブ・ワーズとは、文中に含まれる単語を抽出して数える手法である。
- 二進数表現:単語が存在する場合は1を、存在しない場合は0を入力してください。
- 単語頻度(TF)は、文書内で単語が出現する回数をカウントし、その数を表示します。場合によっては、文書内で出現する正確な単語を見つけることが不可能なため、0と表示されるエントリが多数存在する場合があります。
- 逆文書頻度(IDF)は、対象となるすべての文書において、ある単語が何回出現するかをカウントします。
- 用語頻度-逆文書頻度(TF-IDF)は、TFとIDFという2つの方法を使用します。
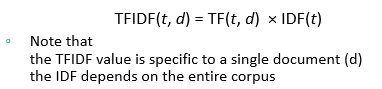
単語の袋を用いる方法を用いると、解釈上の問題が生じる可能性がある。そのため、Nグラムシーケンスを用いることでこの問題を解決できる。
- Nグラムシーケンスは単語数をカウントし、必要な数の単語を追加します。1語、2語、3語のシーケンスが利用可能です。
機能セットを追加するには、最も重要な機能のみを選択して機能数を削減する機能選択方法を開発する必要があります。これには、より多くのメモリと処理能力も必要になります。
講演者:Phaisan Phadungwiang博士、
R&D BI株式会社
編纂者:Nuchanat Rongrong
www.rdbi.co.th
#コンサルタント
#データサイエンティスト
#ビッグデータ分析
#テキスト分析
#テキストデータ管理手法
( データサイエンスの基礎に関する記事を含む)
詳細については、 https://demo.rdbi.co.th/contact/ にアクセスするか、
LINE公式アカウント( @rdbi)
で
。