研修日程:2019年11月14日~15日、21日~22日、28日~29日(計6日間)。研修内容:
データサイエンスと機械学習入門、Hadoop、HDFS、YARN、MapReduce、Spark、Sparkプラットフォーム入門、データサイエンティストの役割、データエンジニアの役割。詳細は、続きをお読みください。
コースの目標
– 教師あり学習と教師なし学習の両方を含む機械学習モデルの動作原理と挙動を理解する。
– タスクに適した機械学習モデルを選択する。
– 分析対象データ(一般データとビッグデータ)に適したツールを選択する
。 – 機械学習のトレーニング用にデータを適切に準備する。
– 最適なグループ数を自動的に識別し、各グループ内の類似した行動に基づいて顧客をグループ化する。
– さまざまなデータセットを使用して予測モデルを作成する。
– 類似したユーザーエクスペリエンスのデータを使用して、ユーザーに推奨事項を提供する。
データサイエンスと機械学習入門
この記事では、データサイエンティストに必要なスキルを紹介し、機械学習の応用例を示します。
ビッグデータとは…
構造化データ、非構造化データ、半構造化データは、膨大な数のレコード(1日あたり100万件以上)を含む大規模で、非常に複雑です。これらのデータのすべて(保存、処理、検索、分析)を管理するには、1台のコンピュータでは不可能です。
構造化データの例としては、表形式のデータ、データベース、ERPシステムやCRMシステムのデータなどが挙げられます。
非構造化データの例としては、テキストファイル、画像、音声、動画などが挙げられます。
非構造化データは構造化データよりも管理が難しく、より高度なスキルが必要となります。
教師あり機械学習モデルと教師なし機械学習モデルの違いは、教師ありモデルでは実世界のデータと事前に定義された予測モデルが必要となる点にあります。例えば、猫の画像の結果を予測するには、モデルを構築するために多数の猫の画像が必要となり、それぞれの画像を猫と識別し、それ以外を猫ではないと識別します。そして、新しい猫の画像が入力されると、モデルはそれが猫かどうかを予測できるようになります。一方、教師なしモデルは、特定の対象を識別できないデータを使用して構築されます。
優れたモデルを構築するには、データをモデル構築とテストのために訓練セットとテストセットに分割する必要があります。訓練セットとテストセットは、データポイントをランダムに選択して作成する必要があります。データセット全体を使用するとパターン認識につながり、予測不可能なモデルになってしまうため、全データセットを使用することは避けるべきです。
Hadoop入門
Hadoopは、データをより小さなクラスターに分割することで、大規模なデータセットの管理を支援するソフトウェアライブラリです。
Hadoopコンポーネント(バージョン2.x以降)には以下が含まれます。
Hadoop分散ファイルシステム(HDFS)は、大きなファイルをブロックに分割するのに役立ちます。一般的なブロックサイズは128MBで、通常は3つのブロックに分割され、それらが複製されて複数のマシンに保存されます。
– Yet Another Resource Negotiator: YARN は計算を支援します。
MapReduceは、大規模なデータセットを並列処理および生成するために使用されるプログラミングモデルであり、アルゴリズムを使用してクラスタを作成します。
MapReduceプログラムは、データのフィルタリング、ソート、および要約に役立ちます。
– ラボ:クラウドプロバイダー上でのHadoopサービス
R&D BIトレーニングチームは、Google Cloud Platformへの申請方法と、Google DataProc上にHadoopクラスターを構築する方法について説明しました。
– ビッグデータ分析のためのPythonとSpark入門
『Python入門』は、Pythonプログラミングの基礎を紹介し、データサイエンスにおけるPythonの活用法を提案する。
Spark Platformの仕様は、画像に示すとおりです。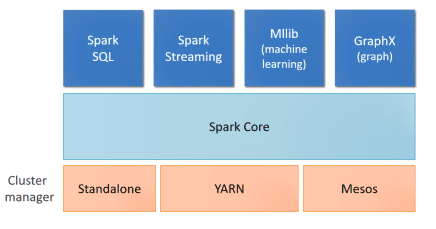
Sparkプラットフォームを使用する場合、データサイエンティストの一般的な作業負荷は以下のとおりです。
主な業務は分析とモデル構築です。SQL、統計学、予測モデリング、Python/MatlabまたはRを用いたプログラミングの経験に加え、データを分析に適した形式に変換する技術経験が求められます。
– Spark Shell、Jupyter Notebook、およびZepperlin Notebookを使用したデータ分析のワークフロー。
データエンジニアの職務内容は以下のとおりです。
主な業務は、本番環境におけるデータ処理アプリケーションを作成することです。
続いて、ファイサン教授は学生たちに実験室での説明と指導を行い、実験ファイルを確認し、PythonとSparkのスクリプトの書き方を説明した。
ヌチャナット・
ロンロン氏と
R&D BI Co., Ltd.
このコレクションには、 ビッグデータ分析
と データサイエンスの基礎に関する記事が含まれています。
詳細については、 https://demo.rdbi.co.th/contact/ にアクセスするか、
http://bit.ly/rdbipage をご覧いただくか、をフォローする
LINE 公式アカウント@rdbi
か、sales@rdbi.co.th までメールでお問い合わせください。